docs/PHASE10_HANDOFF.md:24-46
Was genau geht kaputt, wenn man Arabisch in Zeichen zerlegt?
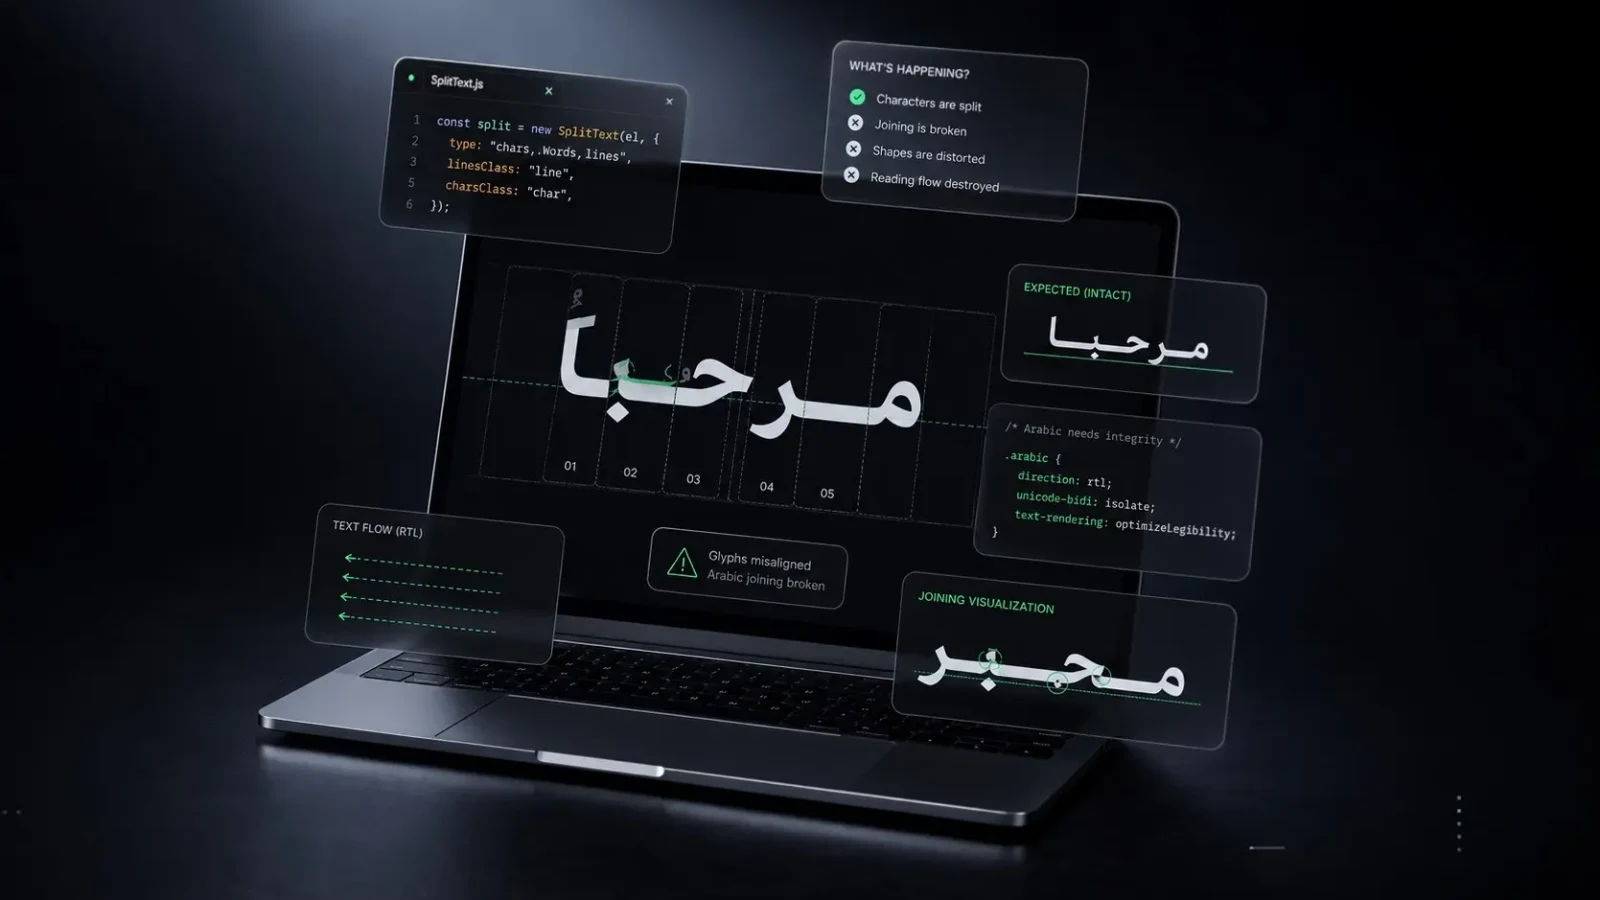
Die arabische Startseite ging mit lauter falsch geschriebenen arabischen Wörtern online. Jedes Wort mit einem Zeichen-Split rendert als Reihe isolierter Buchstaben mit Lücken dazwischen, und das ist in einer verbundenen Schrift kein Stilfehler, sondern ein Rechtschreibfehler — das eigene fünfbuchstabige Wort der Seite für Kontakt aufnehmen kam als fünf einzelne Formen heraus. Es war wochenlang live, und gemeldet hat es der Betreiber der Seite beim Lesen seiner eigenen Seiten, statt dass eine Prüfung es gefangen hätte.
Zweiundzwanzig der 47 Split-Quellen in diesem Markup fordern chars an, und es sind genau die, denen ein Besucher zuerst begegnet: alle vier Menü-Links, jeder Footer-Link und fünf der Home-Sektionen. Das Phase-10-Handoff hielt 23 chars-anfordernde Quellen und 201 Zeichenknoten auf der englischen Startseite fest, Stand seiner Niederschrift; das heutige Markup misst 22 Quellen, und der Golden-Lauf vom 2026-08-24 misst 187 Knoten. Beide Paare stimmen für ihr eigenes Datum, und genau deshalb trägt jedes eines.
Zwei verschiedene Fehler reisen unter derselben Suchanfrage zusammen, und sie auseinanderzuhalten ist der größte Teil der Arbeit. Der eine ist die Reihenfolge — ein lateinisches Wort im arabischen Dokument, das rückwärts rendert, wofür es eine Lösung aus drei Zeilen CSS gibt. Der andere ist das Shaping — ein arabisches Wort, das seine Verbindungen verliert, wofür es keine gibt. Fast jede Antwort im Netz behandelt beide als ein einziges Problem und verschreibt die Lösung für das erste.
ArabicShaping-17.0.0.txt · 834 entries
Warum ist das ein Verbindungsproblem und kein Rechts-nach-links-Problem?
Ein arabischer Buchstabe hat einen Codepoint und bis zu vier Formen. Unicode 17 sagt es unmissverständlich: Jeder Buchstabe bekommt im arabischen Grundblock nur einen Zeichenwert, egal wie viele kontextabhängige Erscheinungen er zeigt, und ein darstellender Prozess muss die Glyphe nach dem unmittelbaren Verbindungskontext des Buchstabens auswählen. Der Kontext sind die Nachbarn. Nimm die Nachbarn weg, und es bleibt kein Kontext mehr zum Auswählen, also fällt der Shaper jedes Mal auf die isolierte Form zurück.
Welche Buchstaben verbinden und auf welcher Seite, sind veröffentlichte Daten und keine Folklore. Die Ausgabe 17.0.0 von ArabicShaping.txt vom 2025-08-14 trägt 834 Einträge, davon 615 dual-joining und 153 right-joining; der Rest ist left-joining, join-causing, non-joining oder transparent. Wer die Datei lokal parst, wie hier am 2026-08-26, bekommt für jede Zeichenkette, die er ausliefert, eine Antwort pro Buchstabe, und die Tabelle unten gibt sie für das Wort, mit dem das hier angefangen hat.
Hebräisch ist die Kontrolle, die den Streit entscheidet. Hebräisch taucht in ArabicShaping.txt nirgends auf, und die Datei hält fest, dass jeder Codepoint, den sie nicht aufführt, standardmäßig non-joining ist — die Form eines hebräischen Buchstabens hängt also nicht von seinen Nachbarn ab, und eine Box pro Buchstabe nimmt ihr nichts weg. Hebräisch läuft von rechts nach links. Es geht nicht kaputt. Die Leserichtung ist nicht die Eigenschaft, auf die es ankommt.
| Buchstabe | Codepoint | Verbindungstyp | Formen |
|---|---|---|---|
| ت | U+062A | D — Dual_Joining | 4 |
| و | U+0648 | R — Right_Joining | 2 |
| ا | U+0627 | R — Right_Joining | 2 |
| ص | U+0635 | D — Dual_Joining | 4 |
| ل | U+0644 | D — Dual_Joining | 4 |
| ש | U+05E9 | U — nicht in der Datei | 1 |
Die Unterscheidung ist hier ausführbar statt rhetorisch. Das Prädikat, das entscheidet, ob ein Dokument in Zeichen zerlegt werden darf, liest die Sprache und nicht die Leserichtung, und der Unit-Test sichert zu, dass ein als rechtsläufig deklariertes hebräisches Dokument false liefert, während ar, ar-SY und AR alle true liefern. An der Leserichtung festzumachen würde Hebräisch die Zeichen aus einem Grund entziehen, der für Hebräisch nicht gilt, und würde jede verbundene Schrift verfehlen, die von links nach rechts läuft.
CSS Transforms L1 · CR 2019-02-14
Warum kann CSS das nicht beheben?
Der Effekt muss jedes Stück bewegen, und der einzige billige Weg, Farbe zu bewegen, ist transform. CSS Transforms Level 1 definiert ein transformierbares Element als alles, dessen Layout dem CSS-Box-Modell folgt, außer nicht ersetzten Inline-Boxen, Tabellenspalten-Boxen und Tabellenspaltengruppen-Boxen. Ein Zeichen in einem einfachen Inline-Span ist eine nicht ersetzte Inline-Box, also wird die Eigenschaft überhaupt nicht angewendet — fallen gelassen statt zu null aufgelöst.
Dieses Repository hat die Messung, weil der Browser darüber lügt. Chrome meldet die Matrix aus getComputedStyle, ganz gleich ob sie je beachtet wurde, und drei Entwicklungsphasen lang trug jedes Zeichen auf der Seite matrix(1, 0, 0, 1, 0, -70), während sich kein einziges davon um ein Pixel bewegt hatte. Das einzige ehrliche Instrument war, das umgebende Rechteck des Zeichens vor und nach einem Hover zu lesen, bei fester Viewport-Breite.
| Gerolltes Element | Legacy | Rebuild | mit den Regeln |
|---|---|---|---|
| das Button-Label | -24.00 | 0.00 | -20.00 |
| der Menü-Link | -70.00 | 0.00 | -70.00 |
| der Textlink | -15.00 | 0.00 | -15.00 |
Also ist inline-block für den Effekt Pflicht, und inline-block ist eine atomare Inline-Box — ein eigener Formatierungskontext und damit eine Grenze. CSS Text Level 3 verspricht darüber hinweg nichts: Wie eine typografische Zeicheneinheit rendert, die von einer Elementgrenze geteilt wird, ist undefiniert, und die Spezifikation warnt Autoren ausdrücklich, dass das Teilen von Graphemclustern oder Ligaturen durch Elementgrenzen inkonsistente oder unerwünschte Ergebnisse liefern kann. Die beiden Anforderungen schließen einander per Spezifikation aus, nicht per Implementierung.
Es ist schlimmer als eine einfache Wahl zwischen beiden, und dieser Teil fehlt meistens. Die W3C-Gap-Analyse zur arabischen Schrift, aktualisiert am 2026-03-30 und gestützt auf ein Issue vom Februar 2020, hält fest, dass WebKit die kursiven Verbindungen bricht, sobald irgendein Markup ein Zeichen umschließt — noch bevor überhaupt gestylt wird. Gecko und Blink halten die Verbindungen bei Styling, das die Glyphenform nicht ändert, und alle drei scheitern, wenn font-weight, font-style oder font-size über die Grenze hinweg verschieden sind. Markup pro Buchstabe garantiert nichts; inline-block garantiert den Bruch.
fontTools 4.60.2 · zain/*.woff2
Was genau verliert der Shaper in einem Lauf aus einem Buchstaben?
Der Verlust ist zählbar, also lohnt es sich, ihn zu zählen. Alle drei ausgelieferten Zain-Schnitte tragen identische Shaping-Tabellen — je 610 Glyphen und 590 cmap-Einträge, 161.096 Bytes für den Satz — und ihr GSUB trägt 39 Substitutionen für die Anfangsform, 39 für die Mittelform, 83 für die Endform und 36 Pflichtligaturen. Jeder einzelne dieser 161 positionsabhängigen Lookups ist kontextabhängig: Er greift nur, wenn der Buchstabe in einem Lauf mit seinen Nachbarn steht.
Ein Lauf aus einem Buchstaben erfüllt keinen davon, und das Feature für Pflichtligaturen hat nichts zu ligieren. Das ist der ganze Mechanismus, und er erklärt, warum ein Wechsel des arabischen Webfonts nie hilft — die Tabellen sind in jedem ordentlichen arabischen Font vorhanden und korrekt, und eine Box pro Buchstabe macht sie alle wirkungslos. Subsetting macht es schlimmer statt besser: Punkte und Zeichen über und unter der Linie sind eigene Glyphen, die erst beim Rendern zusammengesetzt werden, und ein Subsetter, der wegwirft, was er für unerreichbar hält, wirft sie mit weg. Deshalb gehen diese Dateien mit Absicht ohne Subsetting online.
- 161 positionsabhängige Substitutionen 39 Anfangsform, 39 Mittelform, 83 Endform — jeder einzelne kontextabhängig
- 36 Pflichtligaturen die Lam-Alef-Formen, mit nichts mehr zum Ligieren
- 610 Glyphen pro Schnitt identisch in Regular, Bold und Extrabold
- 0 die in einem Lauf aus einem greifen können der Font ist unschuldig; die Box ist der Fehler
Nichts davon ist spezifisch für die Schnitte, die diese Seite ausliefert. Führ dieselbe Messung über deine eigenen aus, und die Form der Antwort hält: ein dreistelliger Zähler kontextabhängiger Lookups, von denen keiner in einem Lauf der Länge eins greifen kann, und ein Feature für Pflichtligaturen, das ein Split bereits halbiert hat.
Wofür diese drei Schnitte sonst noch gemessen werden mussten — der Zahn, das Alef und das size-adjust, das sie mit dem lateinischen Font zusammenbringt — steht in eine arabische Schrift skalieren, wenn x-Höhe nichts bedeutet.
SplitText 3.15.0 · checked 2026-08-26
Hat GSAP das behoben, und kommt eine Lösung?
Nein, und die Antwort ist überprüfbar statt Glaubenssache. GreenSocks Position steht aktenkundig in einer Forumsantwort von Rodrigo, einem seiner Administratoren, vom 11. August 2023: SplitText wurde nicht für rechtsläufige Sprachen entworfen, dort als Limitierung beschrieben, mit einer offenen Einladung, Verbesserungen vorzuschlagen. Diese Antwort ist das Eingeständnis. Die Dokumentation ist es nicht — sie sagt weiterhin nur, dass SplitText auch mit fremdsprachigen Zeichen hervorragend zurechtkommt, und trägt nirgends einen Hinweis auf verbundene Schriften.
Das Rewrite in 3.13, veröffentlicht am 29. April 2025 und am Tag darauf auf npm, brachte aria-Handling, autoSplit, onSplit, deepSlice, mask und Segmentierung über Intl.Segmenter — und erwähnte rechtsläufige Schriften nirgends. Ein Grep über den veröffentlichten Quelltext von 3.15.0, seit 2026-04-13 npm-latest, am 2026-08-26 nach rtl, direction, arabic, cursive, shap, bidi oder joining liefert nichts, und der Zeichen-Split ist immer noch derselbe Aufruf mit Standard-Granularität wie in 3.13.0.
// SplitText, unverändert von 3.13.0 bis 3.15.0:
//   _charSegmenter = new Intl.Segmenter()

const seg = new Intl.Segmenter()
seg.resolvedOptions().granularity
// 'grapheme' — die Vorgabe, und das ganze Problem

function pieces(word) {
  return [...seg.segment(word)].length
}

pieces('تواصل')   // 5  — five isolated forms, one misspelt word
pieces('العربية') // 7
pieces('لا')      // 2  — an obligatory ligature, cut in half
pieces('عبّود')    // 4  — the shadda stays put: marks survive

// die Plattform liefert die Antwort längst mit, und kein Splitter fragt danach
const byWord = new Intl.Segmenter('ar', { granularity: 'word' })
Es wäre unfair, das einen GSAP-Fehler zu nennen. Jede Bibliothek, die jedes Graphem in eine Box packt, läuft gegen dieselbe Wand, und ein handgeschriebener Split über die Zeichen eines Strings ebenfalls: Die Wand ist CSS Transforms Level 1 plus CSS Text Level 3, keine Implementierung. Die einzige Lösung auf Bibliotheksebene wäre, bei einer verbundenen Schrift auf Wort-Granularität zu segmentieren — was die Plattform längst mitliefert, wie die letzte Zeile des Listings zeigt — und kein verbreiteter Splitter tut das von sich aus.
Intl.Segmenter ist eine echte Verbesserung gegenüber einem Split per regulärem Ausdruck, und es lohnt sich, genau zu sagen, was er verbessert hat. Er hält kombinierende Zeichen bei ihrem Buchstaben, sodass ein Wort mit einem Shadda vier Segmente bleibt statt fünf. Beim Verbinden kann er nicht helfen, denn Verbinden ist keine Frage der Segmentierung — es ist eine Frage des Shapings, entschieden nach der Segmentierung, von den Nachbarn, die die Segmentierung gerade in andere Boxen gesteckt hat.
split-registry.js:131-169 · 10 lines
Die Lösung ist eine andere Einheit, einmal gewählt, an einer Stelle
Sobald akzeptiert ist, dass die Entscheidung nicht in CSS wohnen kann, ist die Lösung klein. Eine reine Funktion nimmt die ausgezeichneten Split-Typen und die Schrift des Dokuments, entfernt chars, wenn die Schrift verbindet, und setzt als Untergrenze Wörter — denn eine Quelle, die nur chars angefordert hat, würde sonst in gar nichts zerfallen, und ein Effekt, der keine Stücke findet, animiert nicht.
Die Browser-Tatsache wird hineingereicht statt drinnen gelesen, und das macht die Funktion zum Gegenstand eines Unit-Tests statt zum Gegenstand des DOM. Die Kette unten ist das Argument, das sie kodiert, und jedes Glied darin ist ein Beleg aus einem der Abschnitte oben.
export const JOINED_SCRIPT_LANGS = Object.freeze(['ar'])

export function isJoinedScript({ lang = '' } = {}) {
  const tag = String(lang).slice(0, 2).toLowerCase()
  return JOINED_SCRIPT_LANGS.includes(tag)
}

function trimmed(type) { return type.trim() }
function notChars(type) { return type && type !== 'chars' }

export function splitTypesFor(raw, script = {}) {
  const types = splitTypesFrom(raw)
  if (!isJoinedScript(script)) return types
  const kept = types.split(',').map(trimmed).filter(notChars)
  // Eine Quelle mit nur chars würde sonst in gar nichts zerfallen,
  // und ein Effekt, der keine Stücke findet, animiert nicht.
  return (kept.length ? kept : ['words']).join(', ')
}
- Der Effekt muss jeden Buchstaben bewegen Transform ist der einzige billige Weg, Farbe auf dem Compositor zu bewegen, also muss jedes erzeugte Stück eine transformierbare Box sein.
- Transform überspringt Inline-Boxen CSS Transforms Level 1 schließt nicht ersetzte Inline-Boxen aus, also muss jedes Stück display inline-block sein. Hier gemessen: -70.00 Pixel wurden ohne diese Regel zu 0.00.
- Eine atomare Box ist eine Grenze Ein inline-block eröffnet einen eigenen Formatierungskontext, also wird jeder Buchstabe zu einem Shaping-Lauf von genau einem Buchstaben Länge.
- Die Lookups werden wirkungslos 161 positionsabhängige Substitutionen und 36 Pflichtligaturen im ausgelieferten Font, von denen keine in einem Lauf der Länge eins greifen kann.
- Das Wort ist falsch geschrieben Jeder Buchstabe fällt auf seine isolierte Form zurück, und der Leser sieht eine Reihe von Formen, wo ein Wort stehen sollte.
- Also wandert die Entscheidung eine Ebene höher Schritt zwei rückgängig zu machen stellt Schritt fünf wieder her und zerstört Schritt eins. Es gibt keine Lösung im Styling, also hört der Split selbst auf, bei einer verbundenen Schrift chars anzufordern.
Drei Effekte verbrauchen die Stücke, und jeder degradiert anders. Der Zeichen-Roll und die gescrubbten Hero-Bahnen fallen über eine dokumentierte Reihenfolge zurück — Zeichen, dann Wörter, dann Zeilen, dann nichts — also rollen und scrubben sie im arabischen Dokument ganze Wörter. Der Ellipsen-Wipe fällt nicht zurück, sondern schützt sich: Die Ellipse öffnet sich weiterhin, die Zeilen laufen weiterhin, und nur der Versatz pro Zeichen fehlt. Das Stylesheet stimmt dem in einem einzigen Selektor zu statt in zwei Regeln, die auseinanderdriften könnten, und hebt hoch, welche Einheit auch immer da ist.
Der ehrliche Preis ist die Körnung. Die englische Startseite trägt 187 Zeichen über 28 Wörter, also 6.68 Stücke pro Wort, hergeleitet aus den Gesamtzahlen der Seite statt Link für Link gemessen, und der Roll versetzt um 0.02 Sekunden pro Stück — ein achtbuchstabiges lateinisches Label versetzt also über 0.14 Sekunden, während ein einwortiges arabisches Label ein einziges Stück hat und gar keinen Versatz. Der Effekt überlebt; seine Körnung wird ungefähr um den Faktor sieben gröber. Wörter sind ohnehin das, was ein arabischer Leser als Einheit wahrnimmt.
Die Einheit zu ändern legte dann einen zweiten Fehler frei, den niemand gemeldet hatte. Der Roll fuhr minus einhundert Prozent einer Zeichenbox, während das arabische Stylesheet die Zeilenbox des Labels längst auf 1.55 geöffnet und den Zwilling, auf den der Roll zielt, auf 2em nach unten geschoben hatte — das eintreffende Wort landete also 0.45em unter dem ausgehenden, auf jedem arabischen Link der Seite. Der Roll liest den Versatz des Zwillings jetzt aus dem berechneten text-shadow, statt eine Zeichenbox anzunehmen, und behält die festgehaltenen Literale nur noch als Untergrenze für Elemente, die keinen Zwilling zeichnen.
Diese 1.55 sind keine Vorliebe, sie sind eine berechnete Untergrenze, und die Rechnung dahinter steht in die gemessene Untergrenze der arabischen Zeilenhöhe.
split-registry.js:181-189 · one read
Wo hat ein Gate pro Dokument Lücken?
Das Gate liest die Schrift des Dokuments einmal, am Wurzelelement, und danach nie wieder. Fünfundfünfzig Quellen auf der Startseite wären sonst fünfundfünfzig Lesungen einer Tatsache, die der Build auf das Dokument geschrieben hat und die sich danach nie ändert — und fünfundfünfzig Gelegenheiten, sie unterschiedlich zu lesen. Das ist richtig für die Kosten und richtig für die Konsistenz, und es macht die Prüfung zu einer Frage über das Dokument statt über den einzelnen Lauf.
Das ist eine echte Einschränkung mit Folgen nach beiden Seiten, und man sagt sie besser, als sie zu verstecken.
- einmal gelesen, nicht fünfundfünfzigmal
- Sprache und Leserichtung schreibt der Build auf das Dokument, und sie ändern sich nie; sie pro Element zu lesen wären fünfundfünfzig Lesungen einer einzigen Tatsache.
- zu breit, und sicher
- Im arabischen Dokument werden chars aus allen 22 chars-anfordernden Quellen entfernt, die lateinischen Läufe darunter eingeschlossen. Diese Läufe verlieren einen feineren Versatz und sonst nichts.
- zu eng, und ein echtes Loch
- Im englischen und im deutschen Dokument tut das Gate nichts — der eine arabische Lauf, den diese Dokumente enthalten, das Label des Sprachumschalters selbst, würde also weiterhin in Zeichen zerlegt.
- im Markup geschlossen
- Dieses Label ist von Hand so ausgezeichnet, dass es in Zeilen zerfällt, während seine beiden lateinischen Geschwister weiterhin Wörter und Zeichen anfordern. Das Markup war mit dem Schluss zuerst da, für das eine Label, das jemandem aufgefallen ist.
- das Argument für den Code
- Ein Schluss, der von Hand gezogen wird, ein Label nach dem anderen, hält bis zum nächsten Label. Zehn Zeilen reine Funktion halten ihn für alle Labels auf einmal.
Eine Prüfung pro Lauf ist möglich, und diese Seite braucht keine. Sie hieße, die Sprache pro Quelle vom nächsten Vorfahren zu lesen, der sie deklariert, und sie erkaufte genau ein korrektes Verhalten, das ein einziges von Hand gesetztes Attribut schon erkauft. Wenn eine zweite Locale mit verbundener Schrift dazukommt oder eine Seite Schriften in Länge mischt, wandert die Lesung nach unten; heute wären es Kosten ohne einen Fehler, auf den man zeigen kann.
Derselbe einsame arabische Lauf in einem lateinischen Dokument entscheidet auch darüber, wie der arabische Font geladen wird — einen einzelnen arabischen Lauf mit unicode-range einfangen.
arabic.css:328-341 · the legacy roster
Die andere Hälfte der Suchanfrage: Warum rendert das lateinische Wort rückwärts?
Der zweite Fehler ist echt, er gehört nicht dem Arabischen, und er hat eine Lösung. CSS Writing Modes Level 4 sagt, dass alle atomaren Inline-Level-Boxen außer ersetzten Inline-Elementen immer als neutrale Zeichen behandelt werden. Ein Zeichen-Split macht jeden Buchstaben zu einer atomaren Inline-Box, also wird ein lateinisches Wort in einem rechtsläufigen Absatz zu einem Lauf aus Neutralen — und ein Lauf aus Neutralen nimmt die Richtung des Absatzes an. Der Bidi-Algorithmus kann ihn nicht retten, weil jeder Buchstabe jetzt sein eigener Lauf ist und dem Algorithmus nichts mehr bleibt, was er zusammenhalten könnte.
Die Legacy-Seite hat eine ganze Liste dieser Form gemessen, alles davon auf ihren eigenen arabischen Seiten, alles davon in lateinischer Schrift geschrieben. Das englische und das deutsche Dokument zeigten jede dieser Zeichenketten richtig herum, und genau das machte es so leicht, die Ursache als arabisches Problem misszuverstehen.
| Wie ausgezeichnet | Wie gerendert |
|---|---|
| LoadAbbod | dobbAdaoL |
| 01 / 04 | 04 / 01 |
| +49 155 67042737 | 6704273715549+ |
| #C4552D | C4552D# |
| @alaaabbod | alaaabbod@ |
| 6 KB JS | KB JS 6 |
Die Lösung sind drei Zeilen, und sie ist eine Lösung für die Richtung, begrenzt auf die Boxen, die ein lateinisches Label im rechtsläufigen Dokument halten. Sie funktioniert, sie ist korrekt, und für das Shaping tut sie überhaupt nichts. Das Nav-Stylesheet sagt es in einem Satz: Shaping ist eine Eigenschaft des Fonts und der Codepoints und wird von keiner der beiden Deklarationen berührt, die Verbindungen sind also das Problem der Split-Registry und nicht das der Regel.
Hebräisch ist von diesem Fehler betroffen und vom anderen nicht, und das ist der sauberste Weg, die beiden auseinanderzuhalten. Ein hebräisches Wort, das in einem linksläufigen Container in Zeichen zerlegt wird, rendert rückwärts, und eine Richtungsdeklaration mit einer Isolation behebt das. Ein arabisches Wort, das in Zeichen zerlegt wird, ist falsch geschrieben, in welcher Richtung du willst.
Sechs weitere Korrekturen genau dieser Form, und der Grund, warum logische Eigenschaften sie nicht auffangen, stehen in den Rechts-nach-links-Fehlern, die logische Eigenschaften übersehen.
golden:rtl · 37/37 · 2026-08-24
Wie hältst du es behoben, wenn niemand mehr hinsieht?
Der Grund, warum das online ging, ist langweiliger als der Fehler und nützlicher. Dem visuellen Testaufbau fehlte eine Locale-Achse: Die Viewport-Datei deklariert keine, die Szenario-Bibliothek hat keine Locale-Logik, und der Capture-Schritt liest die Locale eines Szenarios, wenn kein Szenario eine setzt. Vor dem hier beschriebenen Gate hatte genau ein Werkzeug je eine arabische Seite geladen, und nur, um eine einzige Karte zu fotografieren. Jeder Fehler in diesem Artikel war für eine grün durchlaufende Suite unsichtbar und für jeden offensichtlich, der die Seite geöffnet hat.
Das Gate, das es jetzt hält, richtet sich mit Absicht nur auf den Kandidaten, und das ist zu verteidigen statt zu entschuldigen. Jedes andere Gate in diesem Verzeichnis vergleicht den Rebuild mit dem Golden Master; dieses kann es nicht, weil die arabischen Seiten der Referenz die beiden Schriften ausliefern, die absichtlich ersetzt wurden. Ein Vergleich, dessen Grundlage mit Absicht ungültig gemacht wurde, ist keine Abdeckung — er ist ein roter Lauf hinter einer dauerhaften Ausnahmezeile.
Die tragende Zusicherung ist eine Zeile: Das arabische Dokument hat null Zeichenknoten, und das englische hat mehr als null. Die Begleitprüfung stellt sicher, dass das arabische Dokument noch etwas zum Animieren hat, und meldet 26 Wörter und 43 Zeilen. Die Routen kommen aus dem veröffentlichten Routen-Manifest statt aus einer fest verdrahteten Liste; eine Route, die zur Seite dazukommt, ist also eine Route, die das Gate abdeckt, ohne dass jemand daran denken muss — der hier zitierte Lauf hat 20 arabische Routen erhoben, und das Manifest deklariert heute 19, weil seither eine Projektseite gelöscht wurde.
Jede Zahl oben ist die Messung eines Builds an einem Datum gegen einen lokalen Server, und genau so viel ist so eine Zahl laut dem Mess-Versprechen dieser Seite wert. Was das Datum überlebt, ist ihre Form: Die Zählungen werden zugesichert statt erinnert, das Prädikat ist gegen ein als rechtsläufig deklariertes hebräisches Dokument unit-getestet, und ein Rückfall ist jetzt ein roter Lauf statt einer E-Mail von der Person, deren Name falsch geschrieben wurde.
Drei Sprachen aus einer Quelle auszuliefern ist eines der vier Dinge, um die herum diese Seite gebaut ist — die vier Disziplinen.